虚拟内存——从原理到实战
最后更新:
1.绪言
放假在家躺尸了几天,翻了翻CSAPP,看到主存那部分,突然想起来新买的平板有一个功能就是用辅存去扩容主存,一时间挺好奇的,而且感觉扩容了之后没什么差别(?
于是决定研究一下这背后的原理,从现在开始吧
2.从计算机存储层次结构开始
2.1.时间与空间的权衡
什么是计算机存储层次结构?来用一个简单的比喻说明
假设你是一个学生,坐在书桌前,正在读书
你的大脑是处理器,可以用来处理书本的知识
首先获取最快的是你手上的书,你翻开就能看,但是容量有限,你最多同时能拿两三本书
其次放在书桌上的书获取速度稍慢,你得伸手拿,但速度也不差,只是书桌的位置仍然有限,放不下太多书
于是为了获取更多的书,你得站起来走到房间里的书架前去找书,书架能装的书很多,但是从你站起来到走到书架前,所耗费的时间已经是翻手里的书的几十上百倍了
最后是学校里的图书馆,里面装着海量的书,但是为了拿到书,你得吭哧吭哧下楼跑到图书馆去找
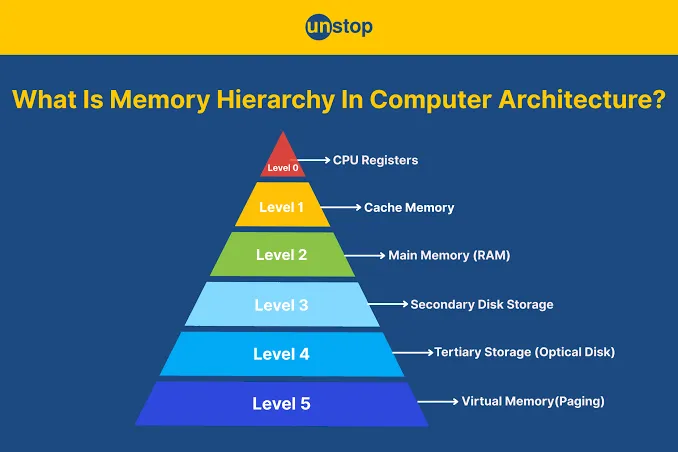
而这就形象地体现了计算机存储层次结构,寄存器就是你的手掌,CPU cache就是书桌,主存就是书架,辅存就是学校的大图书馆
可以看到,从手掌到图书馆,在存储容量扩大的同时,查询速度却在降低,这就是时间与空间的权衡,那有没有查询又快,存储容量又大的存储器呢?搜了一下有NVMe SSD和CXL这种,但成本居高不下,暂时不能作为通用的解决方案,我们今天也不讨论这些,只看怎么在这种权衡的限制下完成任务
2.2.各层次存储器读取速度对比表
现在来以人类的感知为比喻,来比较一下CPU读取各层级存储器的速度
| 存储层级 | 硬件介质 | 典型读取延迟 | 等价于多少CPU周期 | 人类感知等效时间 |
|---|---|---|---|---|
| 寄存器 | CPU核心内部 | < 1 ns | ~1周期 | 1秒(手拿水杯) |
| L1缓存 | SRAM | ~1 - 1.5 ns | ~4 - 5周期 | 5秒(弯腰捡个笔) |
| L2缓存 | SRAM | ~3 - 5 ns | ~12 - 15周期 | 15秒(起身去开门) |
| L3缓存 | SRAM(多核共享) | ~10 - 20 ns | ~40 - 60周期 | 1分钟(下楼拿外卖) |
| 主内存(RAM) | DRAM(DDR4/DDR5) | ~50 - 100 ns | ~200 - 300周期 | 5分钟(去小卖部买个东西) |
| 固态硬盘(NVMe SSD) | Flash(NAND) | ~20 - 100 us | ~100,000+周期 | 1天以上(搭火车跨省出差) |
| 机械硬盘(HDD) | 磁性盘片 + 寻道 | ~5 - 10 ms | ~20,000,000周期 | 7个月(徒步走大半个中国) |
可以看到,越往上,读取速度越快,反之往下,读取速度越来越慢
那你可能要问:啊那我们直接全部按照寄存器的方式制作存储器不就好了吗,当然可以,如果你的钱包撑得住,能折腾,而且能接受你的电脑是个阿尔茨海默症的话
首先寄存器本质上是SRAM,它很贵,特别贵
我们假设你要搞一个1TB存储的存储器,换算一下单位:
然后1个寄存器单元,也就是 的寄存器采用的是6T(6个晶体管)的结构
在目前台积电最顶级的3nm工艺下,一个6T SRAM单元的实际物理面积约为
来乘上来
算上外围电路开销,算 ,大概总共就是
现在光刻机单次曝光极限面积只有大约 ,假设切成单块 的小块进行加工,在3nm的初始缺陷率下,良率大约为
最后实际上需要消耗大约6-7块完整的12英寸晶圆
为了设计你的这个大块SRAM,还需要专门搞一个掩膜版,约为1500万美元,加上晶圆采购大概2万美元一片,算14万美元,以及封装,测试,最终摊下来造出这一块东西就得大概1.1亿人民币
还有电费杂七杂八懒得算了
然后是维护的问题
首先是散热,根据前面的计算,这个巨无霸SRAM总共有约52.8万亿个晶体管,光是待机总功率就有约4400W,运行时功率更是能达到约为30kW
然后算热密度,它总共有大概 大小,热密度约为
如果是局部核心高频读写,局部热密度会瞬间冲到
接下来算最大允许热阻,假设安排 的水,然后芯片最高不能超过 ,允许最大温升为 ,允许最大总热阻为
普通顶级电脑水冷的散热热阻约为 ,传统风冷水冷已经不顶用了
此时如果用流量法水冷,水流量就需要 升 / 秒,水压超级大
最终最好是把整个SRAM阵列完全泡在特定的电子氟化液中,你得整个工业级的高压循环泵和外置冷却塔
最后,为什么说它是阿尔茨海默症?因为SRAM是易失的,也就是关机之后你的所有数据就和你say goodbye了
最最最后,它实际上跑得还是和乌龟一样慢,因为它很大,而光速实际上有上限,在上面走个来回就得有 的光速延迟,相当于CPU空转二三十个周期,如果以现在5GHz的CPU来看
同时还有译码器的那个庞大的逻辑门树,算出来数据在哪里都得几纳秒,以及RC延迟,位线电容暴涨等等
总之,impossible
那你可能觉得很灰暗,难道对存储器的高速访问只能是幻想吗?别沮丧,缓存机制和局部性原理来了
2.3.局部性原理
上面说到,像SRAM这样的存储方式,虽然读取快,但是容量小,易失,且很难做大块,而像DRAM乃至SSD这样的存储器,容量是大了,但是读取又在变慢,那我们的计算机是如何做到响应飞快的呢?
答案就是缓存机制,简单来说,就是上一级永远充当下一级的快速缓存
那么凭什么可以这么做?你怎么就知道需要缓存哪些数据?这是由程序的局部性原理决定的
所谓局部性原理,其实就是针对程序执行过程中的观察从而得出的结论,它主要有两个维度
- 时间局部性:如果一个数据或者指令在某一时刻被访问了,那么在不久的将来它很可能会被再次访问
- 空间局部性:如果一个内存位置被访问了,那么与之相邻的内存位置在不久的将来也很可能被访问
那么根据局部性原理,假设你刚刚用过一个变量,CPU并不将变量丢掉,而是放在缓存中,这样后续再调用时,就能高速获取
程序是否拥有良好的局部性,对于性能的影响是较大的,我们接下来来看一个体现局部性重要性的经典例子
#include <chrono>
#include <iostream>
#include <vector>
int main() {
const int N = 8192;
std::vector<int> a(N * N);
for (int i = 0; i < N; ++i) {
for (int j = 0; j < N; ++j) {
a[i * N + j] = i + j;
}
}
long long sum1 = 0, sum2 = 0;
auto start1 = std::chrono::high_resolution_clock::now();
for (int i = 0; i < N; ++i) {
for (int j = 0; j < N; ++j) {
sum1 += a[i * N + j];
}
}
auto end1 = std::chrono::high_resolution_clock::now();
auto start2 = std::chrono::high_resolution_clock::now();
for (int j = 0; j < N; ++j) {
for (int i = 0; i < N; ++i) {
sum2 += a[i * N + j];
}
}
auto end2 = std::chrono::high_resolution_clock::now();
auto row_time = std::chrono::duration<double, std::milli>(end1 - start1).count();
auto col_time = std::chrono::duration<double, std::milli>(end2 - start2).count();
std::cout << "按行遍历时间: " << row_time << " ms\n";
std::cout << "按列遍历时间: " << col_time << " ms\n";
std::cout << "sum1 = " << sum1 << ", sum2 = " << sum2 << '\n';
return 0;
}最终输出结果:
按行遍历时间: 137.738 ms
按列遍历时间: 1194.69 ms
sum1 = 549688705024, sum2 = 549688705024可以看到这其中有将近十倍的效率差距,为什么会这样呢?
原因是按行遍历符合步长为1的引用模式,而按列遍历的步长则为 ,由于缓存倾向于存储在空间上排布较为相近的变量,结果就是一个可以完美读到缓存,一个每次都需要直接读取内存
2.4.内存管理地址分类
在计算机内存管理中,涉及四种核心地址:物理地址、逻辑地址、线性地址、虚拟地址
它们本质上是硬件架构和操作系统在不同发展阶段对内存抽象的产物
数据在计算机中大致有如下转换流向:
flowchart LR
    A[逻辑地址] -- 分段机制<br>Segmenting --> B[线性地址/虚拟地址]
    B -- 分页机制<br>Paging --> C[物理地址]
下面分别解释四种地址的含义与差别
- 物理地址:它相较为简单直接,对应的就是硬件级内存单元的编号,CPU的地址引脚直接把这个信号发往内存总线
- 逻辑地址:这个是机器指令中用来指定操作数或者代码的地址,表现形式为
[段选择符 : 段内偏移量],是16位8086时代留下来的历史包袱,如今保留为兼容设计 - 线性地址:这是逻辑地址经过分段机制处理后得到的平坦连续地址空间,有计算公式
- 虚拟地址:这与我们今天的主题虚拟内存关系紧密,它实际上是操作系统给每个进程”画饼”所创造出来的独立地址空间
值得注意的是,在现代的64位操作系统中,如在Linux,为了简化内存管理,采用了扁平分段模型,即把所有段的基地址都设置为 0
这样一来,逻辑地址、线性地址、虚拟地址这三个概念可以基本上地等价统一
3.CPU Cache
3.1.CPU三级缓存
回顾一下前面的计算机存储层次结构图,可以看到主存也就是RAM所使用的材料是DRAM,这里简单讲一下寄存器用的SRAM和主存用的DRAM的区别
SRAM即 Static RAM ,静态的,而DRAM就是 Dynamic RAM ,动态
- SRAM内部实际上是一个由晶体管构成的锁存器,只要电源不断,电路自己就能把 或 的状态牢牢锁住
- 而DRAM的数据保存在微型电容中,有电荷代表 ,没电荷代表 ,然而物理规律决定了电容是会漏电的,所以控制器必须不停读出并重写,也就是所谓 Refresh
由于DRAM的这种机制,导致读取数据延迟较高,在性能上比不过SRAM,但优点在于便宜,一个晶体管加上一个电容就OK,而SRAM得要6个晶体管,前面提到过
因此在分级存储机制中,使用可按GB计价的DRAM作为主存
现在有一个问题出现了,DRAM完全跟不上CPU的计算速度,ALU的典型响应延迟大概为 ,而DRAM的响应延迟大概为 ,这中间差着两个数量级,意思就是如果让寄存器直接与DRAM交互,那么大部分的时间都将花在数据读取的路上,这也称作”内存墙”问题
为了解决这个问题,智慧的先人提出了多级缓存模型,尽管一开始并不是三级,但我们这里以常见现代计算机为例说明
既然SRAM快,那么就直接在CPU内用SRAM,外面用DRAM,通过SRAM缓存DRAM数据的策略来进行数据读取加速,这背后就应用到了先前所说的局部性原理
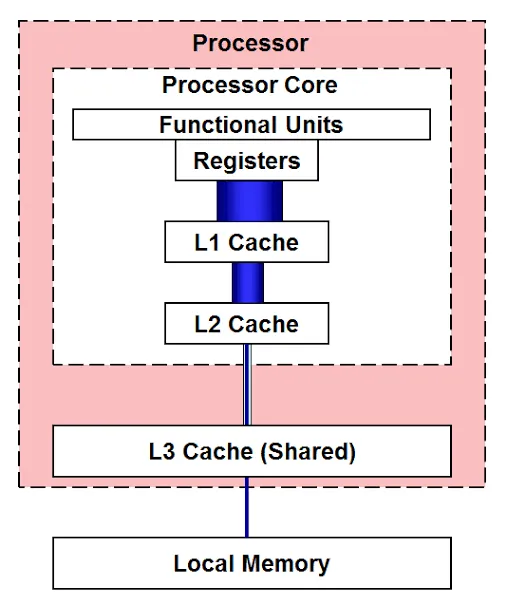
每一层都作为下一层的缓存,其中L1/L2/L3虽然都为SRAM,但是在各自的职能与结构上略有差别
| 缓存层级 | 所在位置 | 共享方式 | 容量范围 | 主要作用 |
|---|---|---|---|---|
| L1 Cache | 核心内部 | 单核独占 | 32 KB ~ 128 KB / Core | 通常分为L1i(指令缓存) 和 L1d(数据缓存),专供CPU核心流水线取指令和存取极高频数据 |
| L2 Cache | 核心边缘或内部 | 单核独占(部分架构为小模块共享) | 512 KB ~ 2 MB / Core | 存放L1经常访问但是装不下的数据 |
| L3 Cache | CPU芯片公用区 | 所有核心共享 | 16 MB ~ 128 MB | 多核协调中心,避免各核心跨总线访问内存 |
3.2.Cache Line
值得注意的是,当 级缓存与 级存储器交换数据的时候,并不是以字节为单位交换的,这样太过低效,而是以缓存行为基本单位交换
Cache Line(缓存行) 是CPU高速缓存(L1/L2/L3 Cache)与主存(RAM)之间交换数据的最小基本单位,一行通常为64字节
为什么要设计Cache Line呢?背后的原因还是局部性原理
一个有好的局部性的程序,在对内存的访问上往往是连续的,所以为了提高效率,CPU推测你接下来还要用附近的数据,所以一次性从内存中读取一整行到缓存中
在缓存行中,并非全部都是内存数据,为了方便CPU管理,它呈现下面的结构:
- Valid Bit:标记这行数据是否合法,
1代表有用,0代表不合法 - Tag:用来比对这行数据到底对应内存里的哪个物理地址
- Dirty Bit:用于标记这行数据有没有被CPU修改过,如果有,在被刷回内存之前必须先写回
- Data Block:真正的数据
3.3.MESI协议
3.3.1.背景
在继续之前,我们需要先介绍一个缓存一致性协议
在多核CPU中,MESI协议是最为经典且应用最广的缓存一致性协议,解决了多个CPU核心各自拥有独立的L1/L2 Cache时,对同一块内存的读写不一致问题
为什么会产生读写不一致?在现代CPU中,采用的是写回策略,假设这样的一个场景,A核修改缓存行中的数据,但是并不会立即将其写回主存,而是添加脏标记,等到这个缓存行被替换后才将修改后的数据写回主存
这样一来就造成了一个问题,当该缓存行还未被写回时,B核从主存中读取该缓存行的数据,就读到了过期数据,违反了一致性
3.3.2.状态定义
因此定义了MESI协议,其中最为核心的是每个核都为其Cache中的每一个缓存行定义了四种状态:
| 状态 | 名称 | 含义 | 与主存数据一致性 | 是否存在于其他核心Cache中 |
|---|---|---|---|---|
| M | Modified(已修改) | 该Cache Line已经被当前核心修改过 | 不一致 | 不存在 |
| E | Exclusive(独占) | 未被修改,且只有当前核心储存了它 | 一致 | 不存在 |
| S | Share(共享) | 未被修改,且有多个核心同时持有这个数据 | 一致 | 存在 |
| I | Invalid(无效) | 该Cache Line中的数据已经失效 | - | - |
3.3.3.运作机制
运作机制大致可以分为两个核心:总线嗅探与事件
首先,每个核心的Cache控制器都在时刻监听总线上的公共读写请求
然后事件分为两类:
- 本核发出的请求(Professor Request):
PrRd:本地CPU读PrWr:本地CPU写
- 总线收到的广播(Bus Request):
BusRd:某个核心因读缺失而发出的广播BusRdX:某个核心因写缺失而发出的广播BusUpgr:某个核心有S数据,但是想写它而发出的广播Flush:将Cache Line数据写回主存或提供给别的核心
3.3.4.状态流转
- 读操作:
- 本地Read Hit:处于
M,E,S状态时,直接读取,状态不变 - 本地Read Miss:处于
I状态时,发送BusRd广播,分两种情况:1.如果其他核心都没有这行数据,从主存中读取,状态设为E;2.如果其他核心有这行数据,响应广播,数据载入后,所有拥有该数据的核心状态设为S
- 本地Read Hit:处于
- 写操作:
M:直接写入,状态仍为ME:直接写入,状态变为MS:发送BusUpgr或者BusRdX广播,其他核心接收到广播后将状态设为I,本地写入后设为MI:发送BusRdX广播,获取最新数据并作废其他核心的副本,写入后设为M
- 监听响应:
- 本地
M,总线BusRd:拦截主存响应,将最新数据发送回请求方并刷新主存,本地状态降级为S - 本地
E,总线BusRd:本地状态静默降级为S - 本地
M/E/S,总线BusUpgr或BusRdX:本地降级为I
- 本地
3.3.5.局限与演进
MESI并非没有缺点,仔细观察可以发现,它会导致CPU频频等待
例如A核想要写状态为S的缓存行,必须要广播并等到所有同为S的核心返回ACK后才能真正写入,极大拖慢了流水线
所以现代CPU引入了缓冲区机制,但这也带来了指令重排的问题,具体不再详谈,这是另一篇文章的问题了
在MESI之后,衍生了诸如MOESI以及MESIF这样的协议,在一定程度上弥补了MESI的不足之处
3.4.伪共享
虽然缓存行在大部分时候提升了程序的效率,但在部分场景下,也会成为导致运行缓慢的凶手
当多线程修改互相独立的变量时,如果这些变量共享同一个缓存行,就会无意中影响彼此的性能,这就叫做伪共享
我们还是举一个例子来说明:
假设有变量A,B共享同一个缓存行,此时核1想要修改变量A,于是广播BusUpgr通知其他核心将该缓存行标记为失效
此时核2又想要修改变量B,发现自己的缓存行已经失效了,于是不得不从核1重新读取,修改的同时,又广播BusRdX,反手又将核1的缓存行标记为失效了
这样一来,两个核明明改的是不同的变量,却因为挤在同一个缓存行中,缓存频频失效,硬件总线占用率大大提高,效率降低
如何解决伪共享?用空间换时间,在两个变量中间填充无用字节,故意让它们隔开64个字节,从而分布到不同的缓存行中
3.5.Cache Mapping
我们在前面已经知道,主存容量大价格低,但是访问较慢,而CPU Cache容量小价格高,但是访问较快,所以利用CPU Cache
首先需要知道,主存内部是由分块结构进行组织的,整个主存被分成一个个主存块,这也是程序在读取主存数据时定位的重要依据
但是当CPU想要访问主存的某个主存块的时候,它是怎么知道这个主存块对应的是CPU Cache中的哪一个Cache Line,从而达成Cache Hit的呢?
这就利用到了 缓存映射(Cache Mapping) 技术
映射的核心在于给出了物理地址之后,如何快速在Cache中找到数据
为了解决这个问题,有三种常见的缓存映射方式,它们之间的不同,主要在于硬件成本、访问延迟以及冲突缺失之间的权衡
- 直接映射:最为简单,主存中的每一个块,只能存放在Cache中固定的一行
- 有映射公式:
- 此时将物理地址划分为Tag、Index、Offset三部分
- 在查找过程中,通过Index直接找到Cache的对应行,然后比对两者的Tag字段是否一致以及Cache内Valid位是否为1,以判断是否Hit
- 优点在于简单直接,成本最低,访问很快,只需要一个比较器;然后缺点就是颠簸(Thrashing)严重,如果程序反复访问两个主存块号模运算结果相同的块,则会频繁相互踢出对方,也就是一直Cache Miss
- 全相联映射:主存中的任意块,可以存放在Cache中的任意一行
- 此时地址被划分为Tag和Offset
- 在查找过程中,就是将Tag字段同时广播给所有Cache Line,然后一个行对应一个比较器进行并行比较
- 优点在于空间利用率高,几乎没有冲突缺失;缺点是硬件极其昂贵且功耗大,有多少个Line就得要多少个并行比较器,且电路延迟会随容量增大而陡增
- 组相联映射:是前二者的权衡折中,它将Cache分为 个组,每个组分为 行,成为 -路组相联
- 此时物理地址被划分为Tag、Set Index、Offset
- 在映射时,先通过
Set Index字段定位到对应的Set,然后这个主存块实际上可以放在这个Set中的任意一行,就和全相联一样,在Set内应用比较器逐行比较Tag,如果Hit了就直接取用
最后可能会疑惑,这个物理地址到底是怎么划分为像Tag、Set Index、Offset这样的字段的?
我们用一个实际案例来说明一下
现在假设有一个大小为32 KB的Cache,其中Cache Line大小为64 B,采用8-路组相联结构
则缓存行行数为
总共有 个Set
现在我们要确定Set Index字段,试想需要多少位才能足够描述这么多Set,自然是 位
同样对于Offset字段,描述所需数据在行内的偏移,行大小为64 B,则也需 位描述
假设这个是32位的物理地址,则最终呈现的结构如下:
| Tag | Set Index | Offset |
20bit 6bit 6bit
---------------------------
32bit3.6.Cache Replacement
显然,缓存的空间是有限的,在组相联模式中,假设某个组内的缓存行全部已有数据,此时又来了一个新的主存块需要缓存,应该剔除哪个缓存行呢?
关于这个策略的选取,就称为Cache Replacement,即缓存替换算法,是解决空间有限而数据无限的核心机制
大致有以下经典策略:
- FIFO:先进先出队列策略,当缓存满时删除时间最久远的一条数据。缺点是完全忽略了数据的访问频次和热度,可能频繁淘汰热点数据,且存在著名的Belady异常:增加缓存容量,命中率反而下降
- LRU:最近最少使用算法,采用哈希表+双向链表实现。缺点是对于批量扫描极其脆弱,一次批量扫描会直接冲刷整个缓存
- LFU:最不经常使用算法,采用访问计数器+小顶堆或者哈希双向链表,每次删除使用频次最低的数据。缺点是历史缓存污染,历史经常访问的数据即使后来热度下降,仍然会处于缓存池中占据缓存空间,需要引入定期衰减机制解决
在现代CPU乃至实际开发中,存在着更多改良的替换算法,需根据实际场景进行选型,但在这里不再展开,这个主题我还是比较感兴趣,以后会在另一篇文章中详谈
3.7.完整Cache访问
接下来我们从CPU的一次指令开始,看一下整个流程是怎样的
首先CPU发出读指令,给出逻辑地址,通过分段机制,转化为线性地址,线性地址再通过分页机制,转换为实际的物理地址
这里以现代计算机常用的组相联映射法为例,物理地址被划分为Tag,Set Index,Offset三个部分
随后根据Set Index字段,查询到对应Set,开始在Set内部通过 个比较器比较Tag
到这里分为两种情况:
- Cache Hit:匹配到对应Cache Line,根据
Offset字段获取对应数据字节 - Cache Miss:缓存未命中,开始匹配下一级缓存,从L1到L2再到L3,重复上面的过程,最后若仍然Miss,则根据物理地址从主存中读取对应数据
需要注意的是,上面的这个流程是串行的简化流程,在现代计算机的实际架构中,往往会采用并行机制以及VIPT以消除地址转换带来的时间损耗,这里不再赘述
本文变更记录
上传了1 - 2.2的内容
更新了CPU Cache相关内容
更新缓存映射与缓存替换,添加内存地址章节
评论
评论会在审核后展示